lunedì 19 gennaio 2015

Creare un programma DIFF (parte 2)

Nel post precedente abbiamo visto come trovare correttamente le differenze fra le righe di due testi, ma quali applicazione ha?
Innanzitutto premettiamo che il metodo visto si può applicare alle righe di un testo, come alle parole, alle lettere, ai puntini che compongono un'immagine, a qualsiasi cosa.
I siti come Dropbox, Google, Mega, offrono di ospitare i vostri file e, ogni volta che aggiornate un file, di mantenere le versioni precedenti. Per risparmiare spazio, invece di avere più copie di file con piccole differenza, mantengono nei loro archivi solo un file e le successive differenze.
Anche nei formati video digitali, ogni 5 fotogrammi, abbiamo i dati di un fotogramma intero e solo le differenze per i successivi 4 fotogrammi; sempre per ridurre spazio.
Trovare le differenza ci serve anche in biologia e medicina, per capire cosa è effettivamente cambiato in un DNA, da una specie ad un'altra, o una lunga molecola organica come si è modificata.
Nel campo dell'informatica, si possono mandare solo i DIFF di un programma, e i programmi di patch, applicheranno solo le modifiche; in questo modo non c'è bisogno di inviare tutto il programma.
Ora vediamo di creare un programma che ci faccia vedere le differenze fra sue testi, molto usato in informatica.
Ci basterà sfruttare il codice mostrato nell'altro post, aggiungendo il solo il modo di colorare il testo.
Otterremo un programma simile a questo:

Nelle due colonne in basso a destra abbiamo i due testi affiancati con le righe eliminate in rosso e quelle aggiunte in verde. Chiamando questi due campi rispettivamente: VersAdiff e VersBdiff, il codice per ottenere il testo colorato è il seguente:

on mouseUp
   #trasformiamo i testi in array, dove ogni riga è un elemento dell'array   
   put the text field "versA" into tOldSource
   put the text field "versB" into tNewSource
   split tOldSource using return
   split tNewSource using return
   #cerchiamo di capire di quanti elementi, cioè righe, è fatto ogni array
   #extents mostra una serie di righe con due numeri, il numero minimo e il massimo per ogni dimensione dell'array
   #qui la dimensione è 1
   put item 2 of the extents of tOldSource into tOldLineCount
   put item 2 of the extents of tNewSource into tNewLineCount
   #calcoliamo le varie sequenze con il massimo testo in comune (LCSL)   
   put CalculateLCSLengths(tOldSource, tNewSource, tOldLineCount, tNewLineCount) into LCLS
   #e adesso calcoliamo il DIFF      
   lock screen
   put empty into field "VersAdiff"
   put empty into field "VersBdiff"   
   DetermineDiff LCLS, tOldSource, tNewSource, tOldLineCount, tNewLineCount
   DetermineDiff2 LCLS, tOldSource, tNewSource, tOldLineCount, tNewLineCount
   unlock screen
end mouseUp

function CalculateLCSLengths tOldSource, tNewSource, tOldLineCount, tNewLineCount   
   #costruiamo la tabella per il calcolo LCSL
   #la riga 0 è tutti 0
   repeat with tRow = 0 to tOldLineCount
      put 0 into pLCSLength[tRow,0]
   end repeat
   #la colonna 0 è tutti 0
   repeat with tCol = 0 to tNewLineCount
      put 0 into pLCSLength[0,tCol]
   end repeat
   #ora calcoliamo le altre varie celle della matrice LCLS
   repeat with tRow = 1 to tOldLineCount
      repeat with tCol = 1 to tNewLineCount
         put tOldSource[tRow] into tOldLine
         put tNewSource[tCol] into tNewLine
         if tOldLine = tNewLine then
            put pLCSLength[tRow - 1,tCol - 1] + 1 into pLCSLength[tRow,tCol]
         else
            put max(pLCSLength[tRow - 1,tCol],pLCSLength[tRow,tCol - 1]) into pLCSLength[tRow,tCol]
         end if
      end repeat
   end repeat
   #finito
   return pLCSLength
end CalculateLCSLengths


#abbiamo un messaggio che chiama se stesso parecchie volte
#qui usiamo le @ per risparmiare meomoria ed evitare troppe copie della stessa variabile, però stiamo attenti a non modificarle!
on DetermineDiff @pLCSLength, @pOldSource, @pNewSource, pRow, pCol
   put pOldSource[pRow] into tOldLine #la riga nel file originale
   put pNewSource[pCol] into tNewLine #la riga nella nuova versione
   if pRow > 0 and pCol > 0 and tOldLine = tNewLine then
      #sono uguali, andiamo alla cella in alto a sinistra rispetto all'attuale nel LCLS            
      DetermineDiff pLCSLength, pOldSource, pNewSource, pRow - 1, pCol - 1
      put the htmltext of field versAdiff into temp
      set the htmltext of field VersAdiff to ( temp & prow & "	" & tOldLine )
   else if pCol > 0 and (pRow = 0 or pLCSLength[pRow,pCol - 1]   >= pLCSLength[pRow - 1, pCol]) then
      ##caso la cella a sinistra è maggiore o uguale di quella sopra
      #è stata aggiunta una riga, moviamoci a sinistra nella tabella LCLS         
      DetermineDiff pLCSLength, pOldSource, pNewSource, pRow,   pCol - 1
      #set the text of field uscita to (field uscita & prow& "+" & tab & tNewLine & return )
   else if pRow > 0 and (pCol = 0 or pLCSLength[pRow,pCol - 1] < pLCSLength[pRow - 1, pCol]) then
      ##caso la cella a sinistra è minore di quella sopra
      #è stata rimossa una riga, saliamo di una riga nella tabella LCLS         
      DetermineDiff pLCSLength, pOldSource, pNewSource, pRow - 1, pCol
      put the htmltext of field VersAdiff into temp
      set the htmltext of field VersAdiff to (temp &"<font bgcolor=red>" & prow & "&#9;" & tOldLine & "</font>" )
   end if
end DetermineDiff

#abbiamo un messaggio che chiama se stesso parecchie volte
#qui usiamo le @ per risparmiare meomoria ed evitare troppe copie della stessa variabile, però stiamo attenti a non modificarle!
on DetermineDiff2 @pLCSLength, @pOldSource, @pNewSource, pRow, pCol
   put pOldSource[pRow] into tOldLine #la riga nel file originale
   put pNewSource[pCol] into tNewLine #la riga nella nuova versione
   if pRow > 0 and pCol > 0 and tOldLine = tNewLine then
      #sono uguali, andiamo alla cella in alto a sinistra rispetto all'attuale nel LCLS            
      DetermineDiff2 pLCSLength, pOldSource, pNewSource, pRow - 1, pCol - 1
      put the htmltext of field versBdiff into temp
      set the htmltext of field VersBdiff to ( temp & prow & "&#9;" & tOldLine )
   else if pCol > 0 and (pRow = 0 or pLCSLength[pRow,pCol - 1]   >= pLCSLength[pRow - 1, pCol]) then
      ##caso la cella a sinistra è maggiore o uguale di quella sopra
      #è stata aggiunta una riga, moviamoci a sinistra nella tabella LCLS         
      DetermineDiff2 pLCSLength, pOldSource, pNewSource, pRow,   pCol - 1
      put the htmltext of field VersBdiff into temp
      set the htmltext of field VersBdiff to (temp & "<font bgcolor=green>" & prow & "&#9;" & tNewLine & "</font>")      
   else if pRow > 0 and (pCol = 0 or pLCSLength[pRow,pCol - 1] < pLCSLength[pRow - 1, pCol]) then
      ##caso la cella a sinistra è minore di quella sopra
      #è stata rimossa una riga, saliamo di una riga nella tabella LCLS         
      DetermineDiff2 pLCSLength, pOldSource, pNewSource, pRow - 1, pCol   
   end if
end DetermineDiff2


Possiamo renderlo graficamente più professionale facendo in modo che muovendo un solo scroller, tutte i due testi scorrano contemporaneamente, mostrando sempre proporzionalmente la stesse parti. Ci basterà levare lo scroll verticale dal campo VersAdiff, e mettere nel secondo campo (VersBdiff) il seguente codice:

on scrollbardrag tdrag
   put the formattedheight of me into myh
   put the formattedheight of field versAdiff into ah
   put tdrag / myh into perc
   put round(perc * ah) into ah2
   set the vscroll of field "VersADiff" to ah2
end scrollbardrag

arrivati a questo punto, affiancandoli bene avremo il risultato voluto.
Come vedete si riesce a vedere bene cosa è stato aggiunto e cosa è stato levato.
Il programma è scaricabile da qui: diff.livecode
Questo tipo di analisi, tipica dell'informatica, è applicabile a qualunque campo. Voi dove l'applichereste?

venerdì 16 gennaio 2015

Creare un programma DIFF (parte 1)

Il post di oggi si applica nei più svariati campi: informatica, biologia, chimica, analisi forense, ecc. Inizialmente lo vedremo dal punto di vista informatico, e poi vedremo perchè si applica a tanti settori diversi. Siccome l'argomento può risultare complesso, vi chiedo di scrivere nei commenti ciò che non vi è chiaro.
Quando si scrive del codice un per un programma, di solito si scrivono delle righe di testo, dove ogni riga rappresenta un comando. Più il programma diventa complesso, più le righe di codice aumentano: si aggiungono comandi, si correggono errori, si torna indietro sul codice scritto e lo si modifica.
Ogni giorno che salviamo il nostro codice, creiamo una versione differente del listato.
Ad esempio prima potremmo scrivere un programma così:
leggi la posta
scrivi a Mario
spegni il pc

e poi il giorno dopo  potremmo modificare il codice con:
leggi la posta
scrivi a Mario
scrivi a Luigi
spegni il pc

e infine il giorno dopo ancora:
leggi la posta
scrivi a Pino
scrivi a Luigi
spegni il pc

Come vedete il programma è stato cambiato tre volte, quindi abbiamo fatto tre versioni diverse del nostro codice. Quando si programma è importante mantenere le versioni precedenti del codice. In questo modo possiamo tornare indietro in caso di errori o analizzare le differenze per capire in un attimo dove è il problema o cosa ha migliorato molto il vostro programma. I programmi DIFF servono proprio a questo, a mostrare le differenze. Sembra facile, ma è molto complicato.
Per capire come fare, dobbiamo prima capire che tipo di modifiche possono essere fatte. Per semplicità ci limiteremo alle righe, che è il caso più diffuso.
In un codice le righe possono essere aggiunte o cancellate. Se uno modifica una riga non fa altro che cancellarla e aggiungerne un'altra al suo posto.
Inserire una sola riga di codice, ad esempio, può dividere in due parti il testo; il DIFF deve riconoscere le parti uguali prima e dopo la riga inserita e segnalarci solo la riga aggiunta. Se facessimo un semplice confronto riga per riga, dalla riga aggiunta in poi il DIFF direbbe erroneamente che è tutto diverso.
DIFF sbagliato
Qui apriamo una piccola parentesi, qualcuno potrebbe dire che ognuno può mostrare le differenze come vuole, basta che portino allo stesso risultato. E' vero che le differenze mostrate nell'immagine sono a loro modo giuste, ma l'unica vera differenza nell'esempio è l'aggiunta della riga suona. La teoria che è dietro al trovare del differenze dice che il miglior DIFF è quello mostra le differenze, scrivendo il meno possibile.
Il DIFF corretto nell'esempio è:
DIFF corretto
Chiaramente va indicato anche dove è la modifica, ma questo è semplice da ottenere. Mi premeva chiarire questo concetto, che la vera differenza è la minima differenza trovabile. Chiusa parentesi.
Ora passiamo al difficile, come si può trovare la minima differenza?
Per fortuna parecchie persone hanno lavorato al problema e hanno trovato una soluzione che è spiegata qui: http://en.wikipedia.org/wiki/Longest_common_subsequence_problem .
Riassumendo semplicemente, bisogna costruire una matrice delle sequenza comuni, tipo questa (v. esempio prima):

0LeggiSuonaScriviSpegni
000000
Leggi01111
Scrivi01122
Spegni01123

La logica per costruirla e semplice, i titoli delle righe e delle colonne della matrice sono formati da 0 e le righe delle due versioni da analizzare, la prima riga e la prima colonna sono formati da zeri. Poi ogni elemento (Xi,Yi) segue le segue le seguenti regole:
  • se  il titolo della riga o colonna corrente è zero, la cella contiene zero
  • se i titoli di riga e colonna sono diversi inserisco il valore più grande tra le celle (Xi-1,Yi) e (Xi,Yi-1), cioè rispettivamente a sinistra e sopra
  • se i titoli di riga e colonna sono uguali inserisco 1 + il valore della cella a sinistra
Costruita una tabella del LCSL genere la si può attraversare partendo dalla casella in basso a destra per creare il DIFF.
Se facciamo uno stack con tre campi: versA, versB, uscita; mettiamo le due versioni dell'esempio ripettivamente in versA e verB. Lanciando il seguente codice:

on mouseUp
   #trasformiamo i testi in array, dove ogni riga è un elemento dell'array   
   put field "versA" into tOldSource
   put field "versB" into tNewSource
   split tOldSource using return
   split tNewSource using return
   #cerchiamo di capire di quanti elementi, cioè righe, è fatto ogni array
   #extents mostra una serie di righe con due numeri, il numero minimo e il massimo per ogni dimensione dell'array
   #qui la dimensione è 1
   put item 2 of the extents of tOldSource into tOldLineCount
   put item 2 of the extents of tNewSource into tNewLineCount
   #calcoliamo le varie sequenze con il massimo testo in comune (LCSL)   
   put CalculateLCSLengths(tOldSource, tNewSource, tOldLineCount, tNewLineCount) into LCLS
   #e adesso calcoliamo il DIFF   
   set the text of field uscita to empty
   put tOldLineCount,tNewLineCount into cella
   DetermineDiff LCLS, tOldSource, tNewSource, tOldLineCount, tNewLineCount
end mouseUp

function CalculateLCSLengths tOldSource, tNewSource, tOldLineCount, tNewLineCount   
   #costruiamo la tabella per il calcolo LCSL
   #la riga 0 è tutti 0
   repeat with tRow = 0 to tOldLineCount
      put 0 into pLCSLength[tRow,0]
   end repeat
   #la colonna 0 è tutti 0
   repeat with tCol = 0 to tNewLineCount
      put 0 into pLCSLength[0,tCol]
   end repeat
   #ora calcoliamo le altre varie celle della matrice LCLS
   repeat with tRow = 1 to tOldLineCount
      repeat with tCol = 1 to tNewLineCount
         put tOldSource[tRow] into tOldLine
         put tNewSource[tCol] into tNewLine
         if tOldLine = tNewLine then
            put pLCSLength[tRow - 1,tCol - 1] + 1 into pLCSLength[tRow,tCol]
         else
            put max(pLCSLength[tRow - 1,tCol],pLCSLength[tRow,tCol - 1]) into pLCSLength[tRow,tCol]
         end if
      end repeat
   end repeat
   #finito
   return pLCSLength
end CalculateLCSLengths


#abbiamo un messaggio che chiama se stesso parecchie volte
#qui usiamo le @ per risparmiare meomoria ed evitare troppe copie della stessa variabile, però stiamo attenti a non modificarle!
on DetermineDiff @pLCSLength, @pOldSource, @pNewSource, pRow, pCol
   put pOldSource[pRow] into tOldLine #la riga nel file originale
   put pNewSource[pCol] into tNewLine #la riga nella nuova versione
   if pRow > 0 and pCol > 0 and tOldLine = tNewLine then
      #sono uguali, andiamo alla cella in alto a sinistra rispetto all'attuale nel LCLS            
      DetermineDiff pLCSLength, pOldSource, pNewSource, pRow - 1, pCol - 1, "uguale"
      #set the text of field uscita to ( field uscita & " " & tab & tOldLine & return)
   else if pCol > 0 and (pRow = 0 or pLCSLength[pRow,pCol - 1]   >= pLCSLength[pRow - 1, pCol]) then
      ##caso la cella a sinistra è maggiore o uguale di quella sopra
      #è stata aggiunta una riga, moviamoci a sinistra nella tabella LCLS         
      DetermineDiff pLCSLength, pOldSource, pNewSource, pRow,   pCol - 1, "aggiungo"   
      set the text of field uscita to (field uscita & prow& "+" & tab & tNewLine & return )
   else if pRow > 0 and (pCol = 0 or pLCSLength[pRow,pCol - 1] < pLCSLength[pRow - 1, pCol]) then
      ##caso la cella a sinistra è minore di quella sopra
      #è stata rimossa una riga, saliamo di una riga nella tabella LCLS         
      DetermineDiff pLCSLength, pOldSource, pNewSource, pRow - 1, pCol, "sottraggo"         
      set the text of field uscita to (field uscita & prow& "-" & tab & tOldLine & return )
   end if
end DetermineDiff


otterremo nel campo uscita:
1+    Suona

Che è il DIFF corretto. Cioè alla riga 1 è stato aggiunto "Suona".
Se proviamo con un testo più lungo, ecco cosa succede:
Vers. AVers. BUscita
This part of the
document has stayed the
same from version to
version.  It shouldn't
be shown if it doesn't
change.  Otherwise, that
would not be helping to
compress the size of the
changes.
    
This paragraph contains
text that is outdated.
It will be deleted in the
near future.
    
It is important to spell
check this dokument. On
the other hand, a
misspelled word isn't
the end of the world.
Nothing in the rest of
this paragraph needs to
be changed. Things can
be added after it.
This is an important
notice! It should
therefore be located at
the beginning of this
document!
    
This part of the
document has stayed the
same from version to
version.  It shouldn't
be shown if it doesn't
change.  Otherwise, that
would not be helping to
compress anything.
    
It is important to spell
check this document. On
the other hand, a
misspelled word isn't
the end of the world.
Nothing in the rest of
this paragraph needs to
be changed. Things can
be added after it.
    
This paragraph contains
important new additions
to this document.
0+        This is an important
0+        notice! It should
0+        therefore be located at
0+        the beginning of this
0+        document!
0+       
8-        compress the size of the
9-        changes.
10-       
11-        This paragraph contains
12-        text that is outdated.
13-        It will be deleted in the
14-        near future.
14+        compress anything.
17-        check this dokument. On
17+        check this document. On
24+       
24+        This paragraph contains
24+        important new additions
24+        to this document.

Corretto ma bruttino da vedere, il DIFF ormai è uno standard che è anche pulito da vedere, quindi cerchiamo di raggruppare le righe consecutive in modo da renderlo più leggibile.
Aggiungendo il seguente codice:

on MouseUp
   put the text of field uscita into old
   set itemdel to tab
   put 0 into cont
   repeat for each line tLine in old
      put item 1 of tLine into variazione
      put char 1 to -2 of variazione into numriga
      put char -1 of variazione into tipo # + o -
      put item 2 of tLine into riga #il testo della riga
      #agg
      if tipo = "+"   then
         if numriga is not oldriga then
            put tipo & numriga & CR after nuovo #il testo riformattato
         end if
         if numriga = oldriga and oldtipo = "-" then
            put tipo & numriga & CR after nuovo #il testo riformattato
         end if
      end if
      if tipo = "-" and ((numriga - oldriga) > 1) then
         put tipo & numriga & CR after nuovo #il testo riformattato
      end if
      put riga & CR after nuovo
      put tipo into oldtipo
      put numriga into oldriga
   end repeat
set the text of field uscita to nuovo
end MouseUp

otteniamo:
+0
    This is an important
    notice! It should
    therefore be located at
    the beginning of this
    document!
   
-8
    compress the size of the
    changes.
   
    This paragraph contains
    text that is outdated.
    It will be deleted in the
    near future.
+14
    compress anything.
-17
    check this dokument. On
+17
    check this document. On
+24
   
    This paragraph contains
    important new additions
    to this document.


Che è proprio come il DIFF usuale, dove il più (+) indica un aggiunta, il meno (-) una cancellazione e il numero dopo il segno a che riga è avvenuta.
Ma ancora siamo a metà del lavoro, nel prossimo posto post vedremo qualche applicazione pratica e utile.

martedì 13 gennaio 2015

Sviluppi futuri

E' stata pubblicata la mappa degli sviluppi futuri di Livecode, la potete leggere qui: http://livecode.com/community/roadmap/

Quello che mi preme sottolineare è quello che hanno messo in coda, non appena un paio di progetti saranno conclusi:
  • includere gli effetti BOX2D: si tratta di tutti calcoli fisici per fare videogiochi o effetti speciali
  • includere l'esportazione per Windows 8 phone, cioè per i cellulari che hanno Windows come sistema operativo.

lunedì 12 gennaio 2015

Code 2014

Si è appena concluso il sondaggio Code 2014, e livecode si è piazzato al 18° posto su oltre 100. Al primo troviamo il Javascript, ma è solo per siti web. Eliminando quelli solo per siti, solo per linux o solo per database rimane la seguente classifica (commentata):

  1. Python, carino ma lo limiterei solo agli script, non ci farete programmi grafici facilmente, anche se esistono delle librerie apposite.
  2. Java, anni fa era l'unica soluzione completa cross-platform, ma oramai è solo un inferno la programmazione. Evitato come la peste dalla maggior parte dei programmatori bravi, ma ancora usato dai vecchi programmatori.
  3. Ruby, carino e completo, ma farete tutto solamente scrivendo codice. Il tempo per sviluppare un software complesso con la grafica risulta molto (troppo) lungo.
  4. C#, carino ma praticamente solo per Windows. Esiste qualche implementazione per Linux, ma non molto.
  5. Delphi, sorpresa! Pensavo che il Pascal fosse un linguaggio archeologico e morto da 20 anni e invece ancora qualcuno lo usa... Incredibilmente pare che si adatti a qualunque sistema operativo... peccato che usi ancora il Pascal... Un linguaggio così vecchio che bisogna ancora dichiarare le variabili prima di usarle...
  6. C: qui siamo alla preistoria dei linguaggi di programmazione, per chi vuole soffrire o non ha a che fare con un computer.
  7. C++: chi usa il C usa anche il C++, perchè bisogna saper farsi del male in più modi.
  8. Go: scordatevi la grafica... solo testo, input e output. Poi compilate, incrociate le dita e avrete il vostro programma senza grafica.
  9. Clojure: come programmare in Java senza usare il Java. Interessante, ma limitatissimo.
  10. Haskell: anche qui scordatevi di fare un programma con finestre e bottoni, a meno che non abbiate molto tempo da perdere.
  11. Scala: anche questo è equivalente a programmare in Java senza usare il Java. Senza grafica, quindi va bene solo se il vostro programma non ha grafica.
  12. Objective-C: l'equivalente di C# nel mondo Apple
  13. Swift: la novità del 2013 una specie di livecode solo per prodotti Apple
  14. LiveCode: il nostro preferito al momento. Completo e veloce.
  15. ...
Ecco qui di seguito alcune considerazioni.
Il fatto che esistano tanti linguaggi di programmazione per la Java Virtual Machine che non usano la sintassi Java, dovrebbe far capire alla Oracle che forse dovrebbero aggiornare il linguaggio. Java è molto usato, ma solo perchè è molto vecchio, la programmazione si sta orientando verso tipi di linguaggi molto più semplici per ottenere programmi: vedi Swift, Livecode o Xojo.
Ruby è carino, ma dovendo scrivere tutto il codice, richiede gruppi di lavoro anche per fare dei semplici programmi. Il suo ambito è più sul web, dove deve rivaleggiare col PHP o Javascript.
C#, Objective-C e Swift sono ristretti a degli ambiti particolari, rispettivamente Windows e Apple, se volete conoscere un linguaggio di programmazione che va bene solo per un sistema operativo, possono dare grandi risultati.
Le vere alternative a livecode si restringono a Java e Delphi, ma entrambi si portano dietro un linguaggio arcaico, pesante e lungo da scrivere, sopratutto il Java ha il limite di essere è quasi indecifrabile.


    venerdì 9 gennaio 2015

    Creare un Plugin

    Livecode è sia un linguaggio di programmazione, sia un ambiente di sviluppo integrato ricco di funzionalità (IDE). Il fatto che sia anche un IDE ci permette di scrivere dei componenti aggiuntivi, plugin, sempre pronti dentro al nostro livecode, che ci permettono di rendere più veloce la nostra programmazione.
    Per creare dei plugin ci basta creare dei programmi livecode, e metterli nella cartella dei plugin, su windows è:
    C:\Documents and Settings\max\Documenti\My LiveCode\plugins

    Per Mac è:
    /Users/max/Documents/My LiveCode/Plugins


    Per Linux è:
    /home/max/my_livecode/Plugins/

    Ovviamente sostituite il nome utente max con il vostro sul computer.
    Se volete utilizzare un'altra cartella per i plugin, potete impostarla andando su Edit -> Preferences -> Files & Memory:

    All'avvio Livecode cercherà tutti i programmi che sono presenti in tale cartella e li integrerà dentro di sè.

    Fate attenzione che un plugin non è modificabile, quindi se dovete cambiarlo o aggiungerci del codice, spostatelo in un'altra cartella.
    Facciamo degli esempi pratici riguardo al codice da mettere in un plugin. Il plugin è uno stack a sè, quindi bisogna fare molta attenzione con i riferimenti.
     Il primo esempio è una libreria, cioè servirà ad aggiungere elementi personalizzati già pronti ai nostri programmi. Per semplicità mettiamo solo un pulsante personalizzato e un pulsante normale, il pulsante normale dovrà essere premuto quando vorremo aggiungere l'elemento ai nostri programmi, così:
    Ora mettiamo il seguente codice nel pulsante Aggiungi pulsante:

    on mouseUp   
       copy button "Stop" of this stack to (the topStack)
    end mouseUp


    Notate che se uno stack è un plugin, non è più considerato da Livecode come lo stack principale (topStack); questo ci permette di fare la differenza tra lo stack su cui lavoriamo e il plugin. Fate attenzione che il codice agirà differentemente se lo stack si trova nella cartella dei plugin o meno!

    Vediamo adesso di creare un plugin che prenda delle informazioni dal controllo selezionato sul programma principale. Creiamo uno stack con due campi, chiamandoli larghezza e altezza, e un pulsante così:

    Poi inseriamo nel codice della card queste righe:

    on revSelectedObjectChanged
       if the selectedObject is empty then
          disable field "larghezza"
          disable field "altezza"
          put empty into field "larghezza"
          put empty into field "altezza"
       else
          enable field "larghezza"
          enable field "altezza"
          put the width of the selObj into field "larghezza"
          put the height of the selObj into field "altezza"
       end if
    end revSelectedObjectChanged

    Cosa è il messaggio revSelectedObjectChanged? Non lo trovate sul dizionario, si tratta del messaggio SelectedObjectChanged ma per i plugin. Nella schermata di impostazione dei plugin trovate tutta la lista dei messaggi speciali (Development -> Plugins -> Pluggin Settings):
    I messaggi per i plugin sono identici ai messaggi normali, ma invece di essere inviati alla card o allo stack del programma principale, sono mandati al plugin. Il nome è lo stesso ma ha le lettere rev all'inizio.In questa maniera, quando selezioniamo un controllo sul programma principale, il plugin ci dirà la sua larghezza e altezza. Se non selezioniamo nulla i campi diverranno grigi.
    Mentre nel pulsante mettiamo questo codice:

    on mouseUp
       set the width of the selObj to field "larghezza"
       set the height of the selObj to field "altezza"
    end mouseUp


    In questa maniera possiamo impostare la larghezza e altezza di un controllo selezionato, basta selezionarlo, cambiare i valori nei campi altezza e larghezza e premere il pulsante Aggiorna.
    Riuscite ad immaginare quante cose potete automatizzare con i Plugin? Praticamente tutto!

    mercoledì 7 gennaio 2015

    Rilasciata la versione 7.0.1

    E' stata rilasciata la versione 7.0.1 stabile. Per chi avesse avuto problemi ad installarla, è stata caricata sui server ufficiali una nuova versione per windows, quella presente fino a ieri su alcuni server era corrotta (incompleta).
    Questa versione punta sempre di più al supporto delle lingue straniere, livecode da solo dovrebbe capire la codifica di un testo e anche il verso della scrittura. Per maggior sicurezza sono state aggiunte delle funzioni proprietà specifiche (textDirection, tabAlign, textEncode, textDecode, ecc.).
    Come al solito potete scaricare tutte le versioni da qui:
    http://downloads.livecode.com/livecode/

    Le note di rilascio sono scritte qui: http://downloads.livecode.com/livecode/7_0_1/LiveCodeNotes-7_0_1.pdf


      lunedì 5 gennaio 2015

      Creare una tag cloud

      Oggi vedremo come creare una tag cloud. Ma cosa è una tag cloud? La trovate anche in questo blog, si tratta di una specie indice dove le voci sono messi a nuvola, grandi quando l'argomento è ripetuto nel sito, c'è chi la chiama anche nuvola di parole. Più un argomento è trattato, più grande sarà la voce:
      Ad esempio ogni post scritto su questo blog ha delle etichette (tag) e in basso a destra trovate il tag cloud di questo blog.
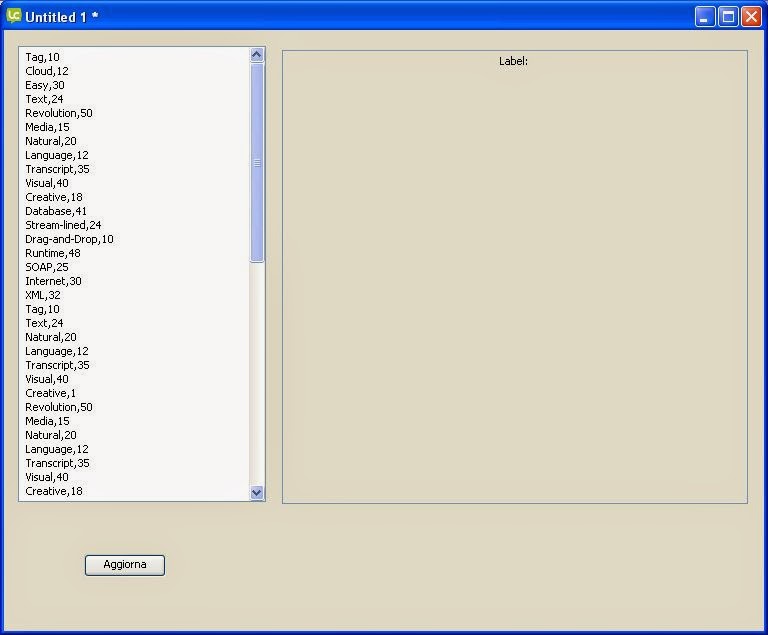
      Creiamo uno stack con due campi di testo e un pulsante:
      Il campo a sinistra lo chiamiamo lista e gli mettiamo una serie di parole seguite da virgola e un numero casuale; il numero rappresenta il numero di occorrenze nel sito.

      Il campo a destra lo chiamiamo tagCloud. Lì apparirà il nostro tag cloud.
      Cerchiamo di riempire tutto il nostro spazio a disposizione, perciò mettiamo nel pulsante il seguente codice:

      on mouseUp
         aggiorna 1
      end mouseUp

      on aggiorna scala
         #prendiamo la lista
         put the text of field lista into tLista
         #calcoliamo il minimo e il massimo delle occorrenze   
         put item 2 of line 1 of tLista into minimo
         put item 2 of line 1 of tLista into massimo
         repeat for each line tLine in tLista
            put item 2 of tLine into temp
            put max(massimo,temp) into massimo
            put min(minimo,temp) into minimo
         end repeat
         #calcoliamo lo scostamento
         put massimo - minimo into delta
         #facciamo in modo da riempire tutto lo spazio a disposizione
         put the height of field tagCloud into maxh
         repeat for each line tLine in tLista
            put item 1 of tLine into testo
            put item 2 of tLine into temp
            put (temp - minimo + 1) / delta into perc
            put round(maxh * perc * scala) into ff #grandezza font
            #assicuriamoci che sia leggibile impostando il minimo font a 8
            if ff < 8 then
               put 8 into ff
            end if      
            put " <font size=" & ff & ">" & testo & "</font> " after tagc
         end repeat
         set the htmltext of field tagCloud to tagc
         if (the formattedheight of field tagCloud ) > maxh then
            aggiorna (scala * 0.9)
         end if   
      end aggiorna

      In questo modo verranno fatti più tentativi, cercando di diminuire il font massimo fino a far entrare tutto nel campo di testo, e il font più piccolo sarà 8. Premendo il pulsante dovreste ottenere un risultato simile a questo:
      Potete anche aggiungere altre proprietà al testo, ad esempio possono essere dei link o molto altro.
      Se avete dubbi, chiedete pure nei commenti.